
Beoordeel legacy data per tabel, entiteit en veld dat een workflow voedt: meet volledigheid, uniekheid en syntactische geldigheid, test representatieve overdrachten op behoud van inhoud, en leg bij de business vast wie de data inhoudelijk accepteert. De data zijn pas voldoende onderbouwd voor workflowautomatisering wanneer meetbaar bewijs, geteste overdracht en formeel eigenaarschap samenkomen; er is geen universele kwaliteitsscore die dit automatisch bepaalt.
Kernpunten: datagereedheid voor workflows
Een werkende koppeling met Microsoft 365 zegt niet dat de brondata bruikbaar zijn. De beoordeling richt zich op de specifieke gegevensstroom, de risico’s van geautomatiseerde verwerking en de verantwoordelijkheid voor inhoudelijke beslissingen.
- Wijs per gegevensdomein een eigenaar aan die bepaalt welke stamdata bruikbaar zijn en welke acceptatiecriteria gelden; technische opschoning vervangt die inhoudelijke goedkeuring niet.
- Beoordeel de gegevenssets die de workflow werkelijk gebruikt afzonderlijk, zodat verschillen in volledigheid, uniekheid en geldigheid niet verdwijnen in een algemeen oordeel over het ERP.
- Voorkom dat onjuiste of onvolledige invoer ongemerkt wordt herhaald: een integratie geeft bronrecords door, maar beoordeelt hun zakelijke betekenis niet automatisch.
- Test vóór ingebruikname of representatieve gegevens zonder inhoudsverlies door de koppelvlakken gaan, met afzonderlijke aandacht voor afgekaptte tekens en foutieve datumconversies.
- Leg per veld vast welk systeem leidend is, wie verantwoordelijk is en in welke richting gegevens synchroniseren, zodat bronregels niet pas tijdens verwerking ontstaan.
- Behandel openstaande ongeldige of ongeclassificeerde records als een inhoudelijke beslisvraag: zonder beschikbare domeinkennis kunnen zij de voorbereiding en livegang vertragen.
Automatisering kan pas steunen op data met een toegewezen eigenaar
Voor een legacy ERP is datagereedheid geen oordeel dat IT alleen kan afgeven. Stamdata krijgen hun betekenis binnen het bedrijfsdomein: daar wordt bepaald welke gegevens voor een relatie, artikel of ander bedrijfsgegeven bruikbaar zijn. Daarom ligt het formele eigenaarschap van die data bij de domeineigenaar. Die verantwoordelijkheid maakt ook duidelijk wie de acceptatiecriteria vaststelt voor gegevens die Microsoft 365-workflows gaan voeden.
Dit voorkomt dat opschoning wordt verward met inhoudelijke goedkeuring. IT kan records voorbereiden voor verwerking, maar een technische bewerking legt niet vast of de aangepaste stamdata voor het betreffende domein aanvaardbaar zijn. Als de opschoning uitsluitend als IT-taak is georganiseerd, blijft die beoordeling openstaan. Het assessment heeft dan wel een technische inventarisatie, maar geen formeel besluit over welke gegevens veilig als invoer voor een workflow mogen dienen.
De eerste grens ligt dus bij de toewijzing van verantwoordelijkheid: per domein moet vaststaan wie de stamdata beoordeelt en op basis van welke acceptatiecriteria. Pas dan kan onzekerheid over onvolledige of inconsistente ERP-records worden omgezet in een inhoudelijk gedragen oordeel, zonder het moeilijk wijzigbare kernsysteem zelf te hoeven aanpassen.
Bronnen bij deze sectie: isaca.org
Een workflow verspreidt ook fouten die bij invoer onopgemerkt blijven
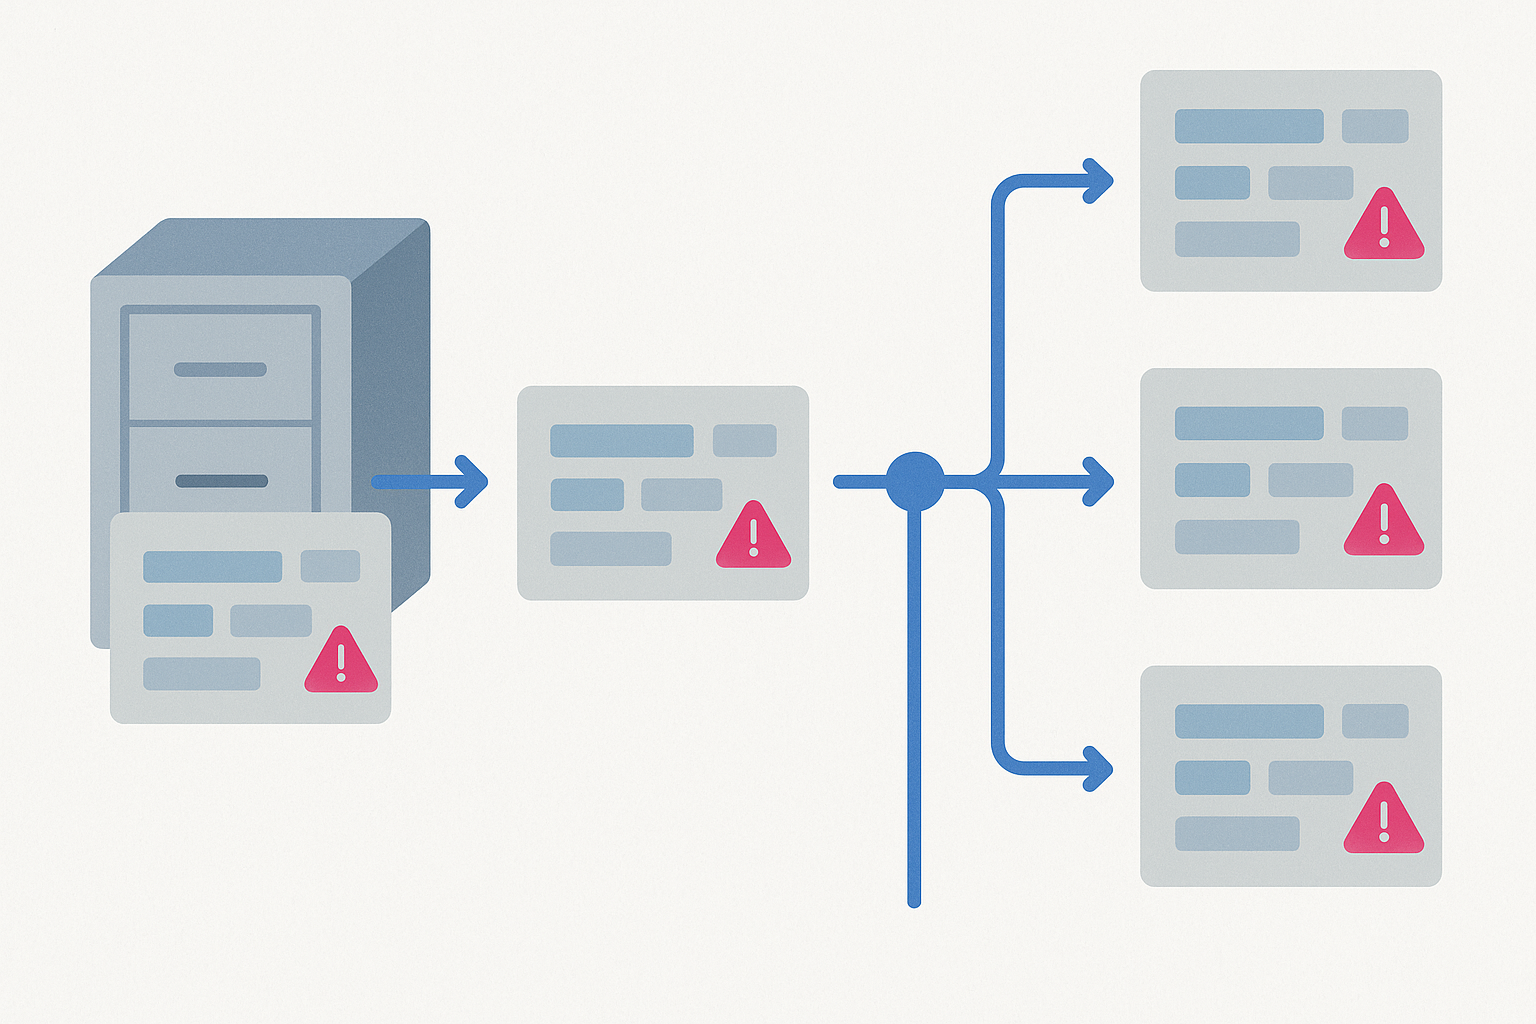
De kwetsbaarheid ontstaat al bij het vastleggen van gegevens in het legacy ERP. Als er per gegevensdomein geen vaste afspraken zijn over de inhoud van velden en niemand formeel verantwoordelijk is voor die velden, ontbreekt vaak ook een controle op de invoer. Een onjuist of onvolledig record kan dan als normaal bronrecord in het systeem blijven staan. Zolang medewerkers het record handmatig behandelen, valt zo’n afwijking mogelijk niet op. Zodra dezelfde gegevens een Microsoft 365-workflow voeden, wordt die invoer echter herhaalbaar verwerkt zonder dat de inhoud onderweg vanzelf wordt beoordeeld.
De integratielaag geeft het record door en herstelt daarmee geen tekortkomingen in de bronregistratie. Ook kan schema drift, bijvoorbeeld wanneer een velddefinitie of veldindeling wijzigt, ertoe leiden dat een overdracht anders wordt geïnterpreteerd dan verwacht. Een technisch werkende aansluiting is daarom geen vervanging voor broncontroles. Foutieve of verkeerd geïnterpreteerde brondata kan ongecorrigeerd in geautomatiseerde stappen terechtkomen, waardoor de uitkomst van de workflow even onbetrouwbaar wordt als het record waarop deze steunt. De haalbaarheid van workflowautomatisering rond een legacy ERP hangt dus ook af van de vraag of onjuiste invoer en afwijkende schema’s vóór de uitwisseling worden onderkend.
Bronnen bij deze sectie: isaca.org
Een eigenaarschap-vacuüm houdt ongeldige stamdata buiten bereik
Bij legacy ERP-integraties vallen ongeclassificeerde artikelen en ongeldige stamdata vaak pas op wanneer records voor een workflow worden geselecteerd. Het afwijkende record aanwijzen is dan nog geen oplossing: iemand moet bepalen welke classificatie of inhoudelijke correctie geldig is. Die beoordeling vereist kennis van het product-, financiële of operationele domein waarin het record wordt gebruikt. Zolang de vakafdeling daarvoor geen materiedeskundige heeft aangewezen, blijven deze records openstaan in de voorbereiding.
Zo ontstaat een wachtrij die niet met extra technische werkzaamheden verdwijnt. De integratie kan verder worden voorbereid, maar de betreffende gegevens kunnen niet als bruikbaar worden afgerond zolang de inhoudelijke herclassificatie uitblijft. Als ongeclassificeerde artikelen en ongeldige stamdata zich opstapelen zonder toegewezen behandeling, kan dat de voorbereiding en livegang vertragen. De beperking ligt dan in de beschikbaarheid van mensen die de betekenis van de stamdata kunnen vaststellen, niet in het leggen van de koppeling met Microsoft 365-workflows.
Bronnen bij deze sectie: isaca.org
Meet datagereedheid per tabel en entiteit, niet op ERP-niveau
Een oordeel als “het ERP bevat goede data” is te grof voor workflowautomatisering. De relevante meeteenheid is de afzonderlijke tabel of entiteit die gegevens aan een workflow levert. Een Data Readiness Scorecard maakt die afbakening expliciet door per tabel en entiteit afzonderlijke scores voor volledigheid, uniekheid en syntaxvalidatie te tonen. SQL profiling scripts vormen daarbij de herleidbare meetbasis: zij leggen vast waarop de scores zijn gebaseerd, in plaats van dat een algemene indruk als bewijs geldt.
| Onderdeel van de scorecard | Wat de score zichtbaar maakt | Meetbasis |
|---|---|---|
| Tabel of entiteit | De afzonderlijke gegevensset waarop de beoordeling betrekking heeft. | De scorecard ordent de bevindingen per tabel en per entiteit. |
| Volledigheid | De exacte score voor de aanwezigheid van de beoordeelde gegevens binnen die tabel of entiteit. | SQL profiling scripts leveren de meetbasis voor de score. |
| Uniekheid | De exacte score voor uniekheid binnen de beoordeelde tabel of entiteit. | SQL profiling scripts leveren de meetbasis voor de score. |
| Syntaxvalidatie | De exacte score voor de syntactische geldigheid binnen de beoordeelde tabel of entiteit. | SQL profiling scripts leveren de meetbasis voor de score. |
Deze opzet voorkomt dat een oordeel over de ene gegevensset wordt gebruikt als vervanging voor bewijs over een andere gegevensset. Volledigheid, uniekheid en syntaxvalidatie staan naast elkaar, omdat het verschillende kwaliteitsaspecten zijn. Een scorecard die deze dimensies afzonderlijk toont, maakt zichtbaar waar de beoordeling precies over gaat en welk kwaliteitsaspect per tabel of entiteit is gemeten.
De exacte scores krijgen betekenis doordat zij herleidbaar zijn tot SQL profiling scripts. Daardoor bestaat de meetbasis niet uit een algemene verklaring over datakwaliteit, maar uit scripts die de scorecard onderbouwen. Het gesprek over de data kan zo worden teruggebracht tot een benoemde tabel of entiteit en een specifiek kwaliteitsaspect, zonder verschillen tussen gegevenssets achter een algemene ERP-kwalificatie te laten verdwijnen.
De scorecard schrijft geen universele grens voor waarboven automatisering altijd kan doorgaan of waaronder zij altijd moet wachten. De waarde zit in de zichtbaarheid en herleidbaarheid van de metingen. Per relevante tabel of entiteit ontstaat een aantoonbaar beeld van volledigheid, uniekheid en syntaxvalidatie. Daarmee wordt datagereedheid een onderbouwde beoordeling van de gegevens die een workflow werkelijk gebruikt, in plaats van een brede aanname over het volledige legacy ERP.
Bronnen bij deze sectie: nist.gov, informatica.com
Toets exports met representatieve data vóór workflows erop vertrouwen
Een dry run onderzoekt de gegevensoverdracht met representatieve datasets voordat workflows op die overdracht gaan steunen. Kies datasets die de gegevensstroom weerspiegelen die via de Microsoft 365-koppelvlakken wordt verwerkt. Daarmee gaat de test niet alleen over de beschikbaarheid van een export, maar over de verwerking ervan in de beoogde workflowomgeving.
Vergelijk vervolgens de inhoud vóór en na de overdracht. Controleer daarbij expliciet of tekens zijn afgekapt en of datumwaarden onjuist zijn geconverteerd. Dit zijn afzonderlijke controlepunten: een overdracht zonder karakterafkapping zegt op zichzelf niets over de juistheid van datumconversies, en omgekeerd.
De uitkomst van de dry run levert bewijs over het behoud van de gekozen dataset tijdens overdracht. Zij vervangt niet de eerder vastgelegde inhoudelijke acceptatie van de brondata, maar vult die aan met een controle op de feitelijke verwerking door de koppelvlakken.
Wie bepaalt welk systeem per veld leidend blijft?
De bronregel hoort vóór de aansluiting formeel vast te liggen. Een Single Source of Truth-matrix benoemt per veld welk systeem leidend blijft. Daarmee wordt de bronregel niet als algemene afspraak over systemen beschreven, maar gekoppeld aan afzonderlijke velden. Dat detail is nodig, omdat het leidende systeem per gegeven kan verschillen.
RACI-documentatie vult de matrix aan door het eigenaarschap voor die velden formeel toe te wijzen. De matrix beantwoordt de vraag welk systeem de bron is; de RACI-documentatie maakt zichtbaar wie verantwoordelijk is voor het veld. Geen van beide vervangt de andere.
Leg naast bronregel en eigenaarschap ook de synchronisatierichting vast. De aansluiting volgt dan een vooraf beschreven gegevensstroom, in plaats van een richting die pas tijdens verwerking wordt ingevuld. Een algemene afspraak dat het ERP leidend is, blijft daarvoor te ruim: die laat open welk systeem voor elk afzonderlijk veld als bron geldt.
De aansluiting kan pas worden beoordeeld wanneer bewijs en verantwoordelijkheid samenkomen
Een beoordeling van legacy ERP-data krijgt pas draagkracht wanneer de uitkomsten van verschillende toetsen bij elkaar kunnen worden gehouden. Kwaliteitsmetingen maken afwijkingen in brondata bespreekbaar doordat zij niet bij een algemene indruk blijven. Validatie van de gegevensoverdracht richt zich vervolgens op de vraag of de gegevensinhoud tijdens verwerking behouden blijft. Formeel data-eigenaarschap legt daarnaast vast waar de inhoudelijke acceptatie van stamdata thuishoort. Deze elementen beantwoorden geen varianten van dezelfde vraag, maar begrenzen elk een ander deel van de onzekerheid rond een workflowaansluiting.
Het samenbrengen van bewijs en verantwoordelijkheid maakt duidelijk waar een beoordeling nog niet af is. Meetbare criteria zonder inhoudelijke acceptatie laten de status van de brondata open. Een overdrachtscontrole zonder een verantwoordelijke voor stamdata laat open wie beslist over de bruikbaarheid ervan. Omgekeerd kan formeel eigenaarschap geen vervanging zijn voor zichtbare kwaliteitsmetingen of voor validatie van behoud tijdens verwerking. De beoordeling wordt pas bruikbaar wanneer elk onderdeel aantoonbaar een plaats heeft in de voorbereiding.
Dit is geen universele grens die foutloze workflows belooft. Het is een grens voor de onderbouwing van het besluit om workflowautomatisering te overwegen. De organisatie kan dan onderscheiden welke afwijkingen in brondata zichtbaar zijn gemaakt, wat tijdens gegevensoverdracht is gecontroleerd en waar de inhoudelijke acceptatie is belegd. Daarmee verschuift de discussie van een algemene verwachting over het legacy ERP naar controleerbare uitspraken over de gegevensstroom die een workflow gaat voeden.
Blijven gegevensstromen ongetest of onbeheerd, dan wordt herstelwerk pas zichtbaar nadat de workflow is aangesloten. Dat verplaatst operationele druk naar een fase waarin de gegevens al door geautomatiseerde verwerking lopen en herstelwerk niet meer vooraf kan worden afgerond.
Bronnen bij deze sectie: isaca.org