
Zorg na implementatie voor langdurig eigenaarschap door per onderdeel van de keten expliciete verantwoordelijkheden, verbindings- en herstelgrenzen vast te leggen, de volledige gegevensstroom te monitoren en een vaste route voor triage en escalatie te hanteren. Stem het beheer af op het integratiepatroon: synchrone koppelingen vragen directe opvolging van latentie, time-outs en retries, terwijl asynchrone koppelingen ook actieve bewaking van gebufferde en vastgelopen berichten vereisen. Borg de,
Kort samengevat: beheer van hybride legacy-integraties
Duurzaam beheer draait niet om de beschikbaarheid van losse servers, maar om aantoonbaar werkende transacties tussen cloud, gateway, netwerk en lokaal ERP.
- Maak vooraf duidelijk welke ketenonderdelen onder beheer vallen en wie beslist, uitvoert en herstelt bij afwijkingen.
- Monitor transactieverwerking, slaagpercentages, latentie, connectorwerking en berichtophoping naast infrastructuurstatus, zodat een draaiende server geen vals geruststellend signaal geeft.
- Leg meetbare verwerkingseisen en grenzen voor automatische herstelpogingen vast, zodat duidelijk is wanneer een storing van automatisch herstel naar menselijke opvolging gaat.
- Behandel schemawijzigingen en uitgeputte retries als ketenincidenten: onderzoek eerst waar gegevens niet meer aansluiten en escaleer voordat procesproblemen zichtbaar worden.
- Voorkom dat synchrone time-outs uitgroeien tot druk op de lokale database door retrygedrag operationeel te begrenzen en toe te wijzen.
- Toets een beheerpartner op aantoonbare deskundigheid én expliciete servicegrenzen voor cloudworkflows, gateway, netwerk en lokale afhankelijkheden.
Langdurig beheer begint bij het gekozen integratiepatroon
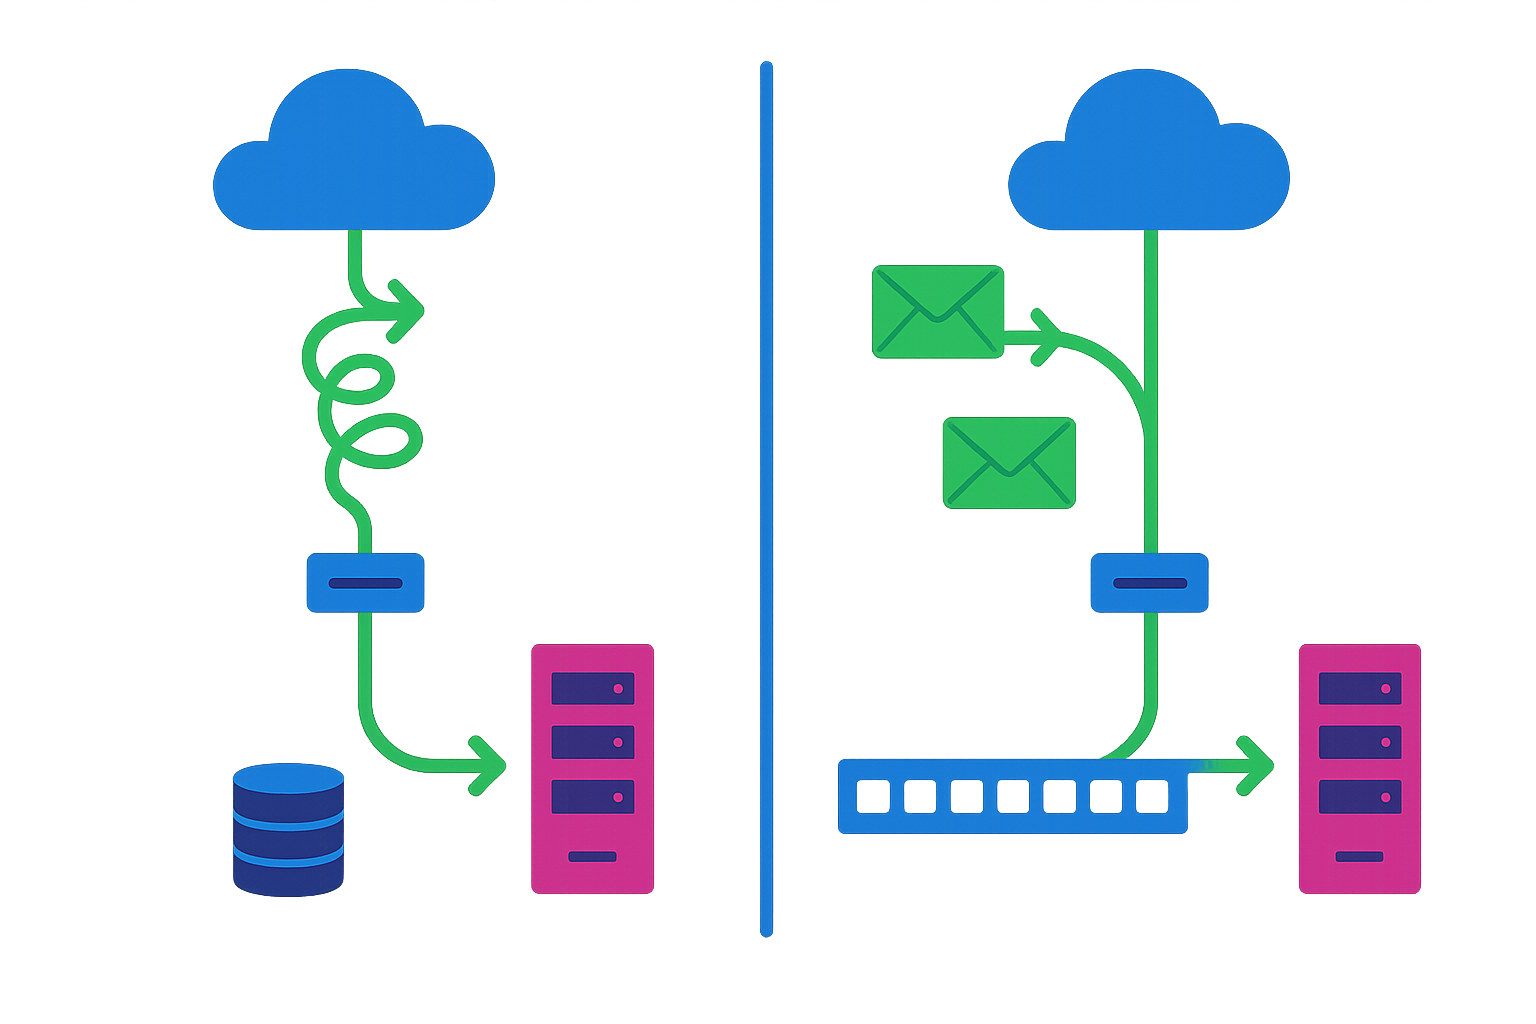
De beheerlast van een hybride legacy-integratie wordt al bepaald door de manier waarop gegevens door de koppeling bewegen. Bij een directe synchrone aanroep wacht een cloudstroom op antwoord van het on-premises systeem. Dat maakt de keten gevoelig voor netwerklatentie: vertraging aan de lokale zijde wordt onmiddellijk zichtbaar in de cloudstroom. Ook tijdelijke onbeschikbaarheid van het legacy-systeem werkt direct door, omdat de aanroep pas kan slagen wanneer de volledige route beschikbaar is. Voor de beheerorganisatie betekent dit dat een afwijking in de verbinding of in het lokale systeem snel een kwestie van directe opvolging wordt.
Die afhankelijkheid wordt sterker wanneer I/O of databasequeries in het on-premises systeem traag zijn of een timeout bereiken. Synchrone HTTP-verzoeken vanuit cloudstromen kunnen dan herhaalaanroepen starten. Zonder asynchrone message buffering via Azure Service Bus kunnen die retries zich opstapelen tot retry storms. De backend krijgt daardoor niet alleen de oorspronkelijke verwerking te verwerken, maar ook een groeiend aantal nieuwe pogingen voor hetzelfde probleem. De belasting kan exponentieel oplopen. Een storing die begon als vertraging verandert dan in druk op de legacy-backend zelf.
Asynchrone ontkoppeling behandelt tijdelijke onbeschikbaarheid anders. Een message broker, zoals Azure Service Bus, kan berichten opvangen wanneer het legacy-systeem tijdelijk niet beschikbaar is. De verwerking hoeft dan niet vast te blijven zitten aan het moment waarop het lokale systeem antwoord kan geven, terwijl de berichten niet verloren gaan. Dat verschuift het beheeraccent: niet alleen directe beschikbaarheid telt, maar ook de toestand van de gebufferde berichten en het moment waarop de verwerking weer doorgaat.
Daaruit volgt een praktische grens voor eigenaarschap na go-live. Bij synchrone koppelingen hoort het beheer voorbereid te zijn op directe gevolgen van latentie, timeouts en herhaalaanroepen. Bij asynchrone ontkoppeling ligt de aandacht mede bij de buffer als tijdelijke opvang. CloudSphere beschouwt dit onderscheid tussen directe aanroepen en buffering als uitgangspunt om te bepalen welk gedrag na een afwijking gevolgd moet worden. Wie het patroon niet expliciet maakt, kan ook niet helder vaststellen welke signalen onderhoud en herstel moeten aansturen.
Bronnen bij deze sectie: Azure Architecture Center: Asynchronous messaging options
Een groene server bewijst niet dat de integratieketen werkt
Een server kan na een herstart als beschikbaar worden gemeld, terwijl de gegevensstroom die ervan afhankelijk is al is gestopt. Neem een Windows Server die na een maandelijkse patchcyclus opnieuw opstart. De On-Premises Data Gateway kan vervolgens starten met een verlopen certificaat of een proxyfout. De integratieconnector faalt dan, maar server-uptime monitoring geeft geen alert omdat de server zelf wel draait. Het groene signaal zegt in dat geval niets over de verwerking tussen cloud en ERP.
De gevolgen worden pas later zichtbaar. Wanneer connectorfouten onopgemerkt blijven, kan de data-inconsistentie tussen cloud en ERP wekenlang stil oplopen. Het probleem is dan niet uitsluitend dat een component niet bereikbaar is. De relevante vraag is of transacties de hele keten hebben doorlopen en of de gegevens aan beide kanten nog overeenkomen. Monitoring na go-live heeft daarom zicht nodig op de connector en de transactieverwerking, niet alleen op de status van de onderliggende server.
Voor tijdelijke uitval van een on-premises applicatie biedt asynchrone ontkoppeling met Dead-Letter Queues een ander verloop. Berichten worden persistent gebufferd totdat het achterliggende legacy-systeem weer beschikbaar is. De uitval verdwijnt daarmee niet uit beeld, maar hoeft evenmin automatisch dataverlies te betekenen. Beheer kan onderscheid maken tussen een bericht dat wacht op herstel en een transactie die niet meer verder komt.
Dat onderscheid verandert ook de betekenis van een alert. Een uptime-melding controleert of een server actief is. Ketensignalen moeten duidelijk maken of een connector na de herstart functioneert, of transacties nog worden verwerkt en of berichten zich in de buffer verzamelen. Pas met die combinatie ontstaat een bruikbaar beeld van de werkelijke toestand van de hybride koppeling. Duurzame supportafspraken krijgen daardoor een concrete inhoud: opvolging gaat over de keten die gegevens verplaatst, niet alleen over een server die antwoord geeft.
Bronnen bij deze sectie: Azure Architecture Center: Asynchronous messaging options
Leg verbindingseisen en herstelgrenzen vast vóórdat alerts worden ingericht
Alerts worden pas toetsbaar wanneer de verbinding en het verwachte verwerkingsgedrag vooraf scherp zijn afgebakend. Leg daarom onderstaande voorwaarden vast als onderdeel van de integratieketen.
- Maak de verbindingsroute expliciet. Microsoft On-Premises Data Gateway en Azure Relay initiëren uitsluitend uitgaande verbindingen via poort 443, met HTTPS/WSS. Deze voorwaarde beschrijft waar de communicatie begint: vanuit de eigen omgeving naar buiten, zonder inkomende poorten open te stellen. Voor monitoring betekent dit dat de beoordeling zich richt op de beschikbaarheid van deze uitgaande communicatie voor de gateway of relay. Een alert zonder vastgelegde verbindingsroute maakt het lastig om te bepalen of een afwijking in de keten of buiten de keten ligt.
- Leg de doorlooptijd voor near-realtime verwerking vast. Voor near-realtime berichtenverwerking via Azure Service Bus geldt een doorlooptijd van minder dan 2.000 ms. Dit is de grens waartegen de feitelijke verwerking kan worden afgezet. Daardoor wordt latentie geen abstract signaal, maar een afwijking die binnen de afgesproken verwerkingseis kan worden beoordeeld. De grens hoort bij dit specifieke scenario met Azure Service Bus en kan niet stilzwijgend als algemene norm voor iedere koppeling worden gebruikt.
- Beperk automatische retries vooraf. Automatische herhaalaanroepen blijven begrensd tot maximaal 3 tot 5 pogingen met exponentiële backoff. De combinatie van een maximumaantal pogingen en toenemende wachttijd voorkomt dat een mislukte verwerking onbeperkt blijft terugkeren. Daarmee is ook duidelijk wanneer automatische herstelpogingen zijn uitgeput en verdere opvolging nodig wordt. De retrygrens geeft het beheer een herkenbaar omslagpunt tussen tijdelijk automatisch herstel en een afwijking die niet langer door nieuwe pogingen mag worden vergroot.
Bronnen bij deze sectie: On-premises data gateway architecture, Azure Architecture Center: Asynchronous messaging options
Laat een schemafout via dashboard, triage en escalatie door de keten lopen
Een schemawijziging in een legacy-ERP laat zien waarom een vaste incidentroute nodig is. Het dashboard levert signalen voor de eerste beoordeling; het herstelt de oorzaak niet zelfstandig. De route hieronder houdt de aandacht bij de gegevensstroom voordat ontbrekende orders pas veel later zichtbaar worden.
- 1. Zie de afwijking in de operationele gegevens. Lever bij oplevering een operationeel Azure Monitor- en Power BI-dashboard mee dat realtime inzicht geeft in transactievolumes, slaagpercentages en latentie. Deze drie gezichtspunten beantwoorden verschillende vragen: neemt het aantal transacties af, voltooit een kleiner deel de verwerking, of duurt de verwerking langer? Samen maken ze zichtbaar dat de keten afwijkt, ook als een afzonderlijke component nog bereikbaar lijkt. Bij een vermoedelijke wijziging in het ERP vormt dit de feitelijke basis voor de eerste triage.
- 2. Koppel het signaal aan de eerste systeemgrens. Een veldlengte- of schemamutatie in het legacy-ERP kan ertoe leiden dat Microsoft 365 Power Automate-flows vastlopen op schema-validatiefouten. Onderzoek richt zich dan eerst op de overgang van ERP-gegevens naar de flow: welke velden of structuur sluiten niet meer aan? Daarmee blijft de analyse beperkt tot de keten waar de afwijking zichtbaar is, in plaats van uit te gaan van een algemene storing in Microsoft 365 of het lokale systeem.
- 3. Beoordeel de automatische verwerking als afzonderlijke fase. Wanneer schema-validatiefouten blijven bestaan, kunnen automatische retries uitgeput raken. De stromen falen dan stil wanneer er geen P1-alert volgt. Het dashboard maakt zichtbaar dat transacties niet meer slagen; de triage moet vervolgens vaststellen dat retries geen nieuw herstel meer opleveren. Dit moment scheidt een tijdelijke afwijking van een situatie waarin de verwerking niet verdergaat en onderzoek over de systeemgrens nodig wordt.
- 4. Escaleer vóórdat de procesafwijking pas achteraf wordt ontdekt. In deze foutketen kunnen medewerkers ontbrekende orders anders pas bij de kwartaalafsluiting aantreffen. De escalatie volgt daarom op het samengaan van schema-validatiefouten, uitgeputte retries en afwijkende transactiegegevens, niet op een latere administratieve ontdekking. De route maakt helder welk onderzoek volgt nadat de automatische stroom is stilgevallen en voorkomt dat de ketenfout buiten de operationele opvolging blijft.
Toets eigenaarschap per ketenonderdeel met een RACI-matrix
Een RACI-matrix is pas bruikbaar als zij niet over de integratie als één geheel spreekt, maar de grenzen binnen de keten afzonderlijk vastlegt. Gebruik onderstaande controles om een gedetailleerd opleverdocument op volledigheid te toetsen.
- Cloudstromen staan als eigen onderdeel in de matrix. Controleer of de cloudstromen afzonderlijk zijn opgenomen en of de RACI-toewijzing voor dit onderdeel expliciet is. Een algemene regel over “de cloud” laat open welk deel van de gegevensverwerking onder het eigenaarschap valt. De matrix moet daarom duidelijk maken dat cloudstromen een afgebakende grens hebben, los van de gateway, de verbinding en de lokale database.
- De gateway heeft een zelfstandige verantwoordelijkheidsgrens. Verifieer dat de gateway niet impliciet onder cloudstromen of netwerkverbindingen is geplaatst. De gateway vormt een afzonderlijk ketenonderdeel tussen de cloudzijde en de lokale omgeving. Een gedetailleerde RACI-matrix maakt deze grens zichtbaar, zodat de gateway bij onderzoek en herstel niet tussen andere componenten verdwijnt.
- Netwerkverbindingen worden niet samengevoegd met de gateway. De verbinding is een eigen onderdeel van de keten en vraagt dus een eigen plaats in de matrix. Controleer of de RACI-matrix duidelijk onderscheid maakt tussen verantwoordelijkheid voor de gateway en voor de netwerkverbindingen. Dat onderscheid voorkomt dat een afwijking aan de verbindingskant zonder aangewezen opvolging blijft omdat alleen het gatewayonderdeel is beschreven.
- Lokale ERP-databases zijn expliciet toegewezen. Toets of de lokale ERP-databases als afzonderlijke grens zijn opgenomen. De database hoort niet slechts als achtergrond van de integratie te worden genoemd. Wanneer dit onderdeel ontbreekt, eindigt de toegewezen verantwoordelijkheid vóór de plek waar lokale gegevensverwerking plaatsvindt.
- Behandel de matrix als opleverbaar bewijsstuk. De RACI-matrix moet vooraf en gedetailleerd worden opgeleverd. Daarmee is zij controleerbaar vóórdat beheer nodig is. Eigenaarschap na go-live wordt zo beoordeeld op zichtbare grenzen in plaats van op een algemene toezegging over ondersteuning.
Onbegrensde retries kunnen een timeout veranderen in procesuitval
Een HTTP 504 is in een synchrone integratie niet alleen een melding van vertraging. In combinatie met parallelle herhaalaanroepen kan deze timeout de belasting op de legacy SQL-database vergroten en uiteindelijk operationele kantoorprocessen stilleggen.
- De fout begint bij netwerklatentie rond de gateway. Wanneer de gateway netwerklatentie ondervindt, kan een synchrone Logic App een HTTP 504-timeout genereren. De directe aanroep krijgt dan niet tijdig het verwachte antwoord. Op dat moment is de oorzaak nog verbonden aan vertraging in de route, maar de verwerking is al niet meer gewoon voltooid.
- De cloudflow reageert met herhaalaanroepen. Na de timeout initieert de cloudflow retries. Dat gedrag voegt nieuwe aanroepen toe terwijl de eerdere verwerking niet is afgerond. Het risico zit niet alleen in één nieuwe poging, maar in het feit dat de cloudflow aanvullende verwerking blijft starten tegen een systeem dat al onder druk staat.
- Parallelle queries bereiken de legacy SQL-database. De retries sturen parallelle queries naar de legacy SQL-database. Hierdoor verplaatst het probleem zich van de gateway en de synchrone Logic App naar de lokale gegevenslaag. De database ontvangt meer gelijktijdige verwerking terwijl de oorspronkelijke vertraging nog niet is opgelost.
- Databasevergrendeling wordt een procesprobleem. Door de parallelle queries kan de legacy SQL-database vergrendeld raken. In deze foutketen kan dat uitmonden in volledige uitval van operationele kantoorprocessen. De zakelijke impact ontstaat dus niet los van de technische keten: latentie leidt tot een timeout, de timeout tot retries, en de retries tot databasebelasting en vergrendeling.
- Maak retrygedrag onderdeel van de operationele opvolging. De eigenaar van retrygedrag en de route na een timeout mogen niet onbepaald blijven. Anders wordt een eerste vertraging behandeld als een geïsoleerde connectorfout, terwijl de parallelle verwerking al druk op de database opbouwt. De foutketen laat zien waarom een begrensde reactie nodig is voordat de lokale gegevenslaag het hele kantoorproces raakt.
Kan één beheerpartner Microsoft 365 en legacy-afhankelijkheden dragen?
Dat kan niet worden afgeleid uit een algemene belofte over managed support. Aantoonbare Microsoft-certificeringen van engineers zijn wel een controleerbaar signaal bij de beoordeling, mits zij worden gelezen naast expliciete servicegrenzen voor Microsoft 365-workflows en hun legacy-afhankelijkheden.
- Wat tonen certificeringen wel? Aantoonbare Microsoft-certificeringen geven een zichtbaar aanknopingspunt om technische deskundigheid van engineers te beoordelen. Voor een hybride omgeving waarin Microsoft 365-workflows afhankelijk zijn van lokale onderdelen, is dat relevanter dan een niet-toetsbare omschrijving van algemene ervaring. Het signaal gaat over de engineers en hun aantoonbare kwalificaties; het is geen bewijs dat iedere legacy-omgeving in haar geheel kan worden gedragen.
- Welke certificeringen kunnen worden genoemd? Azure Solutions Architect en Power Platform Solution Architect zijn concrete voorbeelden van Microsoft-certificeringen die in deze beoordeling kunnen worden meegenomen. De eerste past bij de Azure-zijde van de omgeving, terwijl de tweede aansluit bij het Power Platform waarin Power Automate-flows kunnen functioneren. De namen geven richting aan de controle, maar vervangen geen afbakening van de componenten die binnen het beheer vallen.
- Hoe past het Well-Architected Framework hierin? Beoordeel deze certificeringen in relatie tot de richtlijnen van het Well-Architected Framework. Daarmee staat de beoordeling niet los van een herkenbare technische referentie. De certificering wordt een onderbouwd signaal in plaats van een los label. Tegelijk blijft de vraag bestaan welke servicegrenzen daadwerkelijk zijn vastgelegd voor de cloudworkflows en de lokale afhankelijkheden.
- Wat is de beperking van dit signaal? Certificeringen maken geen expliciete verantwoordelijkheidsgrenzen overbodig. Zij bewijzen niet dat ondersteuning voor elke gateway, netwerkverbinding of lokale ERP-afhankelijkheid automatisch is inbegrepen. De partnerfit blijkt pas uit de combinatie van aantoonbare kwalificaties en concrete grenzen voor het beheer. Dat voorkomt dat de reikwijdte na go-live wordt ingevuld op basis van verwachtingen die niet vooraf zijn vastgelegd.
Van oplevering naar beheer: toets de stabilisatie op meetbare ketenprestaties
De overgang van project naar beheer krijgt pas een duidelijke vorm wanneer stabilisatie ook een afgebakende periode heeft. Een contractueel vastgelegde hypercare-stabilisatieperiode van 4 tot 6 weken na go-live maakt zichtbaar dat de eerste fase niet opgaat in onbepaalde nazorg. Binnen die periode kunnen afwijkingen die rond de ingebruikname naar voren komen nog onder een herkenbare overgang vallen, in plaats van later terug te keren als losse vragen zonder vaste plaats in het beheer.
De duur van 4 tot 6 weken is hierbij een vastgelegde stabilisatieafspraak, geen algemene maat voor iedere integratie. De waarde ervan zit in de scheiding die zij aanbrengt: er is een benoemd begin na go-live, een afgesproken periode van stabilisatie en vervolgens een structurele beheerfase. Daardoor kan worden getoetst of openstaande punten daadwerkelijk een plaats hebben gekregen, in plaats van te blijven hangen tussen oplevering en regulier onderhoud.
Periodieke kwartaaloverleggen over integratieprestaties en optimalisaties verlengen deze overgang naar een vast ritme. De gesprekken richten zich niet alleen op een incident op het moment zelf, maar op de prestaties van de integratie en op optimalisaties die aandacht vragen. Zo ontstaat er een terugkerend moment waarop afwijkingen en verbeterpunten niet uitsluitend worden behandeld wanneer iemand opnieuw aan de bel trekt.
De combinatie van hypercare en kwartaaloverleg is daarmee een contractuele toets op doorlopend integratiebeheer. Zonder zo’n overgang kunnen openstaande afwijkingen als losse nazorg terugkomen. Dat leidt tot herhaald onderzoek buiten een vaste beheerstructuur en kan de kosten en verstoring van operationele processen laten terugkeren, terwijl geen afgesproken moment bestaat waarop integratieprestaties en optimalisaties worden opgepakt.