
Start de moderniseringsvoorbereiding direct zodra een component End-of-Life is, niet meer regulier kan worden gepatcht, moeilijk herstelbaar is of grote operationele impact heeft. Wachten kan alleen verantwoord zijn bij actieve Extended Support en beheersbare risico’s; plan de livegang dan in een rustiger bedrijfsvenster, maar gebruik de wachttijd om afhankelijkheden, ontwerp en herstelbaarheid te onderzoeken.
Kernpunten van dit artikel
De juiste timing voor legacy-modernisering wordt per component bepaald door supportstatus, patchbaarheid, herstelbaarheid, onderlinge koppelingen en operationele impact — niet door één algemene vervangingsdatum.
- Maak onderscheid tussen voorbereiding en livegang: een druk seizoen kan een reden zijn om de overgang te verplaatsen, maar niet om onderzoek en ontwerp uit te stellen.
- Behandel systemen zonder reguliere leverancierpatches als urgente voorbereidingsgevallen, ook als zij nog functioneren en er geen zichtbaar incident is.
- Voorkom dat tijdelijke reparaties en verlengd onderhoud structurele vernieuwing blijven verdringen; zij houden de omgeving draaiend maar lossen de onderliggende veroudering niet vanzelf op.
- Valideer vóór het vastleggen van een uitvoeringsvenster welke systemen, scripts, adressen en gegevensstromen door een wijziging kunnen worden geraakt.
- Prioriteer niet alleen op leeftijd: de combinatie van ondersteuning, mogelijkheid tot patchen, beschikbare vervangonderdelen, netwerkpositie en bedrijfsimpact bepaalt de werkelijke urgentie.
- Beschouw isolatie als een factor die directe blootstelling kan verlagen, maar toets herstelmogelijkheden afzonderlijk voordat wijzigingen plaatsvinden.
Wanneer wachten nog kan en wanneer voorbereiding direct begint
De kalender is niet het eerste criterium voor legacy-infrastructuur; de supportstatus is dat wel. Actieve Extended Support betekent dat de leverancier nog patches levert. Daardoor kan een organisatie de uitvoering onder voorwaarden gecontroleerd naar een geschikter bedrijfsvenster verschuiven. Dat is iets anders dan besluiten dat het systeem voorlopig geen aandacht meer vraagt. De beschikbare supportperiode biedt ruimte om de timing te kiezen, maar neemt de noodzaak weg noch vervangt zij de voorbereiding.
Bij volledige End-of-Life verandert de situatie. Er zijn dan geen reguliere vendor-patches meer beschikbaar. In die status is wachten op een volgend laagseizoen geen neutrale planningskeuze, omdat het systeem ondertussen zonder die leverancierondersteuning blijft functioneren. Directe voorbereiding betekent hier niet automatisch een onmiddellijke livegang. Het betekent dat de organisatie de werkzaamheden start die nodig zijn om de uitvoerbaarheid van een verandering vast te stellen, in plaats van pas te beginnen wanneer de bedrijfsagenda ruimte geeft of een incident de planning overneemt.
Dat onderscheid voorkomt een veelvoorkomende verwarring tussen voorbereidingsurgentie en het executievenster. Voorbereiding kan bestaan uit dependency mapping en architectuurontwerp. Deze activiteiten kunnen vóór een drukke bedrijfsperiode worden afgerond, terwijl de daadwerkelijke livegang pas in een laagseizoen plaatsvindt. Zodra die twee onderdelen gereed zijn, rust de keuze voor het uitvoeringsmoment op een beter onderbouwde basis. Een laagseizoen blijft dan een middel om de overgang te plannen, niet een reden om onbekende afhankelijkheden en ontwerpvragen onbepaald te laten liggen.
Extended Support maakt uitstel dus verdedigbaar wanneer die periode wordt benut om de verandering voor te bereiden en de resterende ondersteuning daadwerkelijk actief is. Volledige End-of-Life vraagt om een andere houding: niet noodzakelijkerwijs alles tegelijk vervangen, maar wel onmiddellijk de voorbereiding opstarten. Een datum op de vervangingskalender zegt op zichzelf weinig als niet eerst vaststaat of het component nog patches ontvangt en of de relaties met de rest van de omgeving voldoende in beeld zijn. De livegang mag aansluiten op de bedrijfsdynamiek; de voorbereiding volgt de supportstatus.
Bronnen bij deze sectie: Guidance on the Legacy IT Risk Assessment Framework, Updated definition of legacy IT
Wachten op het perfecte moment kan noodreparaties verlengen
Dat een verouderde omgeving vandaag nog functioneert, zegt weinig over de ruimte om zonder voorbereiding te blijven wachten. Vooral bij software en firmware die End-of-Life hebben bereikt en geen actieve leverancierondersteuning meer hebben, ontstaat een blijvende blootstelling: nieuw ontdekte kwetsbaarheden kunnen niet langer via reguliere security patches worden gedicht. Het ontbreken van een zichtbaar incident maakt die situatie niet tijdelijk minder aanwezig. Het betekent alleen dat het onderliggende probleem nog niet de vorm van een onmiddellijke storing heeft aangenomen.
In deze fase verschuift de aandacht gemakkelijk naar symptoombestrijding. Budget gaat dan naar dure noodreparaties en verlengde onderhoudscontracten voor verouderde hardware. Die uitgaven kunnen nodig lijken om de bestaande omgeving nog draaiend te houden, maar zij veranderen niet automatisch het fundamentele risico van de verouderde basis. Zo ontstaat pleisterbudgettering: middelen blijven naar tijdelijke instandhouding gaan, terwijl de structurele verandering telkens opschuift. De organisatie betaalt dan voor tijd, maar verkrijgt niet vanzelf een beter uitgangspunt voor het volgende bedrijfsvenster.
De combinatie van niet meer regulier patchbare componenten en terugkerende noodmaatregelen verschuift daarom het juiste startmoment naar voren. Niet omdat de volledige uitvoering per definitie direct moet plaatsvinden, maar omdat voorbereiding los kan staan van de uiteindelijke overgang. Door die voorbereiding eerder te beginnen, blijft er ruimte om de geplande verandering rond de bedrijfsvoering te organiseren. Wordt alles uitgesteld tot een defect, dan is de beschikbare tijd vooral gericht op herstel en verlengd onderhoud, niet op een beheerste voorbereiding.
Een nog werkende legacy-omgeving is dus geen zelfstandig bewijs dat wachten veilig is. De relevante vraag is of de omgeving nog regulier kan worden gepatcht en of tijdelijke herstelmaatregelen het risico werkelijk verlagen. Als het antwoord op beide punten negatief is, groeit de kans dat de planning uiteindelijk niet meer door de organisatie wordt bepaald, maar door de noodzaak van een acute reparatie.
Bronnen bij deze sectie: Guidance on the Legacy IT Risk Assessment Framework, Update Business Software, 5 Ways Legacy Systems Hold Back Business
Verborgen koppelingen maken een gepland venster onzeker
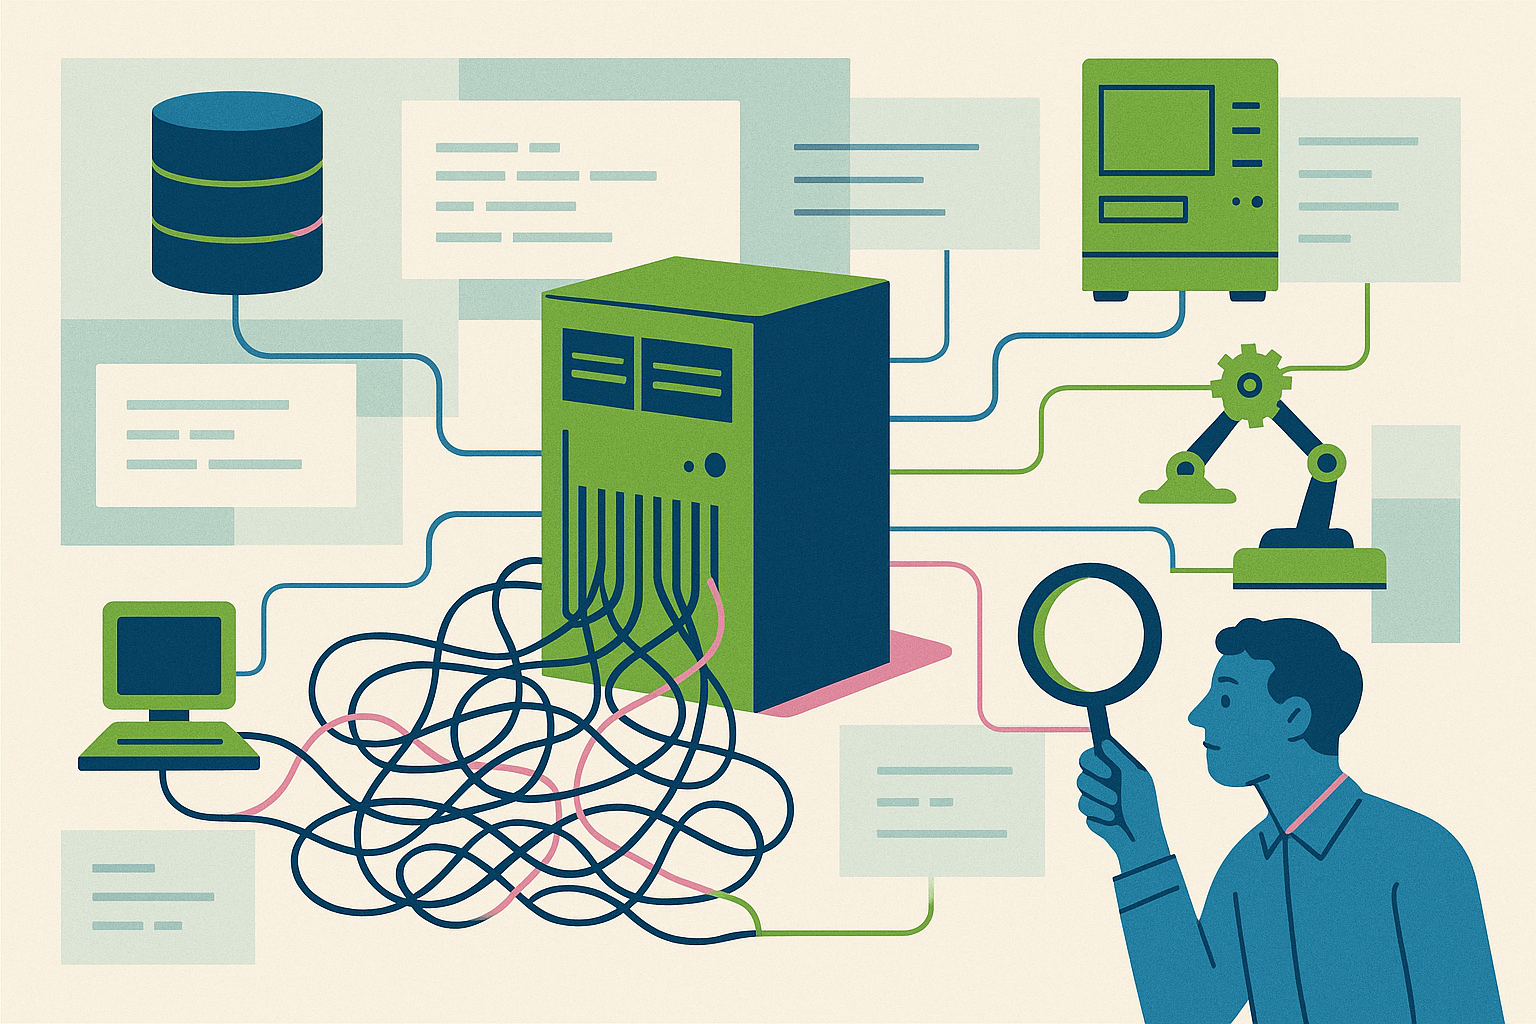
Een beschikbaar uitvoeringsvenster is pas bruikbaar wanneer duidelijk is wat er tijdens een wijziging geraakt kan worden. In legacy-omgevingen verdwijnt contextuele systeemdocumentatie vaak geleidelijk. Ook verdwijnt vakkennis wanneer de mensen die de historische keuzes kennen niet langer beschikbaar zijn. Daardoor wordt een wijziging risicovoller, zeker wanneer extern beheerpersoneel de omgeving moet beoordelen zonder de oorspronkelijke context. Wat op papier een afgebakend component lijkt, kan in de praktijk verbonden zijn met processen die nergens volledig zijn vastgelegd.
Dependency mapping richt zich daarom op de impliciete afhankelijkheden die een planning kunnen ondermijnen. Hardcoded IP-adressen zijn zo'n afhankelijkheid: een adres kan in een relatie tussen onderdelen vastgelegd zijn zonder dat dit in actuele documentatie zichtbaar is. Hetzelfde geldt voor verouderde ODBC-koppelingen en niet-gedocumenteerde batchscripts. Deze voorbeelden hoeven niet te betekenen dat een overgang onmogelijk is. Zij maken wel duidelijk dat een geplande wijziging niet uitsluitend op basis van de zichtbare infrastructuur als uitvoerbaar kan gelden.
De praktische vraag is niet of elke onbekende afhankelijkheid vooraf met absolute zekerheid kan worden uitgesloten. De vraag is of de aanwezige documentatie en vakkennis voldoende zijn om de relevante koppelingen in kaart te brengen vóórdat het gekozen venster als vaststaand wordt behandeld. Als die basis ontbreekt, kan een laagseizoen alsnog te kort of te risicovol blijken zodra een impliciete relatie tijdens de wijziging zichtbaar wordt. Dan was het venster wel beschikbaar in de agenda, maar niet gevalideerd tegen de feitelijke systeemrelaties.
Dit geeft voorbereiding een eigen functie naast de technische uitvoering. Door afhankelijkheden te inventariseren voordat de livegang wordt ingepland, wordt duidelijk welke onderdelen nog nader onderzocht moeten worden en welke aannames te kwetsbaar zijn. De betrouwbaarheid van de planning groeit niet door een datum te reserveren, maar door de relatie tussen componenten, documentatie en beschikbare kennis eerst voldoende zichtbaar te maken.
Bronnen bij deze sectie: Guidance on the Legacy IT Risk Assessment Framework
Deze signalen zetten hardware en patchbeheer bovenaan de planning
Gebruik deze controles om vast te stellen welke hardware- en patchsignalen voorbereiding naar voren halen. Geen van beide controles bepaalt automatisch een livegangdatum; zij tonen vooral waar onverwachte uitval of niet-tijdig gemitigeerde kwetsbaarheden de beschikbare planningsruimte kunnen beperken.
- Controleer leeftijd en herstelbaarheid van fysieke hardware. Inventariseer welke fysieke hardware ouder is dan vijf jaar. Voor deze leeftijd geldt volgens de beschikbare beoordeling een exponentieel hogere faalkans. Beperk de beoordeling niet tot de vraag of het component vandaag nog werkt. Controleer ook of OEM-vervangstukken beschikbaar zijn. Het ontbreken daarvan kan na een defect leiden tot langdurige en onherstelbare downtime. Daarmee wordt de hardware geen component die rustig tot een volgende algemene vervangingsronde kan wachten, maar een component waarvan de herstelbaarheid eerst expliciet moet worden meegewogen. De combinatie van leeftijd en ontbrekende onderdelen ondersteunt voorbereidingsurgentie, omdat een defect het gekozen bedrijfsvenster kan doorkruisen voordat een geplande verandering plaatsvindt.
- Controleer softwarelevenscyclusbeheer vóór End-of-Support. Breng voor software en firmware in beeld waar zij zich in de levenscyclus bevinden en of de aanpak aansluit op richtlijnen voor softwarelevenscyclusbeheer. De bedoeling van deze controle is tijdige mitigatie van kwetsbaarheden voordat systemen End-of-Support bereiken. Dat maakt patchbeheer een planningssignaal en niet alleen een beheeractiviteit achteraf. Wanneer de status pas wordt bekeken nadat ondersteuning is geëindigd, resteert minder ruimte om de overgang op de eigen operationele capaciteit af te stemmen. Een sluitende aansluiting op deze richtlijnen ondersteunt tijdige mitigatie; zij schrijft geen vaste vervangingscyclus voor alle hardwaretypen voor en bepaalt evenmin welke bestemming een component daarna moet krijgen.
Bronnen bij deze sectie: Guidance on the Legacy IT Risk Assessment Framework, Update Business Software
Isolatie verlaagt blootstelling, maar vervangt herstelvalidatie niet
Een lagere directe blootstelling verandert de prioriteit van een component, maar niet de noodzaak om de situatie afzonderlijk te beoordelen. Twee aannames vertekenen die beoordeling regelmatig:
- “Geïsoleerd betekent dat voorbereiding kan vervallen.” De netwerkpositie maakt wel degelijk verschil. Een standalone archiefsysteem achter strikte segmentatie heeft een significant lager direct risicoprofiel dan een centrale authenticatie- of ERP-server. Die vergelijking helpt bij het rangschikken van componenten: niet elk oud systeem draagt dezelfde directe blootstelling. Netwerkisolatie is echter geen bewijs dat voorbereiding of classificatie overbodig is. Het component blijft onderdeel van de timingbeoordeling; de lagere blootstelling is één onderscheidend kenmerk, geen vrijbrief om het buiten de planning te plaatsen.
- “Isolatie bewijst dat herstel tijdens wijzigingen geregeld is.” Netwerkisolatie zegt niet of data en herstelcapaciteit tijdens infrastructurele wijzigingen aantoonbaar geborgd zijn. Daarvoor dienen periodieke en geautomatiseerd geverifieerde back-up- en herstelvalidaties als afzonderlijk controlemoment. Bare-metal restores zijn een genoemd voorbeeld van zo'n validatie. De waarde ervan ligt in het bewijs dat herstelcapaciteit is gecontroleerd, niet in een belofte over een vaste hersteltijd of een gegarandeerde uitkomst. Een component kan dus lager geprioriteerd zijn vanwege strikte segmentatie en toch afzonderlijke herstelvalidatie nodig hebben voordat wijzigingen worden uitgevoerd.
Bronnen bij deze sectie: About the NIST Risk Management Framework
Is wachten op een rustiger seizoen altijd minder riskant?
Nee. Een rustiger seizoen kan de tijdelijke verstoring van gepland migratiewerk beperken, maar het verlaagt niet automatisch het continuïteitsrisico dat tijdens het wachten blijft bestaan. De afweging bestaat uit twee verschillende soorten belasting:
- Gepland werk vraagt tijdelijk capaciteit; uitstel houdt de kans op een noodstop in stand. Tijdens een geplande migratie zijn operationele capaciteit en aandacht tijdelijk nodig. Dat kan een reden zijn om de livegang naar een rustiger periode te verplaatsen, vooral wanneer de bedrijfsvoering in een druk seizoen weinig ruimte laat voor verandering. Die keuze heeft echter een keerzijde. Uitstel vergroot voortdurend de kans dat hardwarefalen of kwetsbaarheden niet in een gepland venster, maar als acute en ongecontroleerde noodstop zichtbaar worden. Dan verdwijnt juist de ruimte om capaciteit bewust vrij te maken. De organisatie handelt dan onder de druk van een storing in plaats van volgens een eigen planning. Wachten is daarom alleen minder riskant wanneer de tijdelijke verstoring die ermee wordt vermeden zwaarder weegt dan het continuïteitsrisico dat in de uitstelperiode blijft oplopen. De vraag is niet welk seizoen altijd het veiligst is, maar of de omgeving de gekozen wachttijd verantwoord kan dragen. Een rustig venster blijft bruikbaar voor gepland werk, terwijl het risico van een acute stop buiten dat venster niet door de kalender wordt opgeheven.
Bronnen bij deze sectie: Guidance on the Legacy IT Risk Assessment Framework, 5 Ways Legacy Systems Hold Back Business
Leg de timingbeslissing vast per component, niet per vervangingskalender

Een bruikbare moderniseringsroadmap begint niet met één gezamenlijke datum voor alle oude onderdelen. Zij begint met een consistente beoordeling per component. Patchbaarheid, ondersteuningsstatus en operationele impact vormen daarbij samen de relevante criteria. Patchbaarheid laat zien of kwetsbaarheden nog tijdig kunnen worden gemitigeerd. De ondersteuningsstatus maakt zichtbaar of er nog leverancierondersteuning is. Operationele impact onderscheidt onderdelen waarvan een verstoring zwaarder doorwerkt van onderdelen met een beperktere directe rol.
Door deze criteria volgens het Legacy IT Risk Assessment Framework toe te passen, ontstaat een vaste basis voor prioritering. Dat voorkomt dat leeftijd alleen als vervangingsargument dient of dat een kalenderjaar de volgorde bepaalt. Twee componenten kunnen beide verouderd zijn en toch een sterk verschillende positie hebben: het ene kan nog patchbaar en ondersteund zijn, terwijl het andere dat niet meer is; hun operationele impact kan eveneens uiteenlopen. De beoordeling maakt die verschillen expliciet, zodat de planning aansluit op de feitelijke risico-eigenschappen van elk component.
Deze aanpak helpt ook om voorbereiding en uitvoering op de juiste schaal te organiseren. Een component met een ongunstige combinatie van patchbaarheid, ondersteuning en operationele impact komt eerder in beeld voor voorbereiding dan een component waarvoor die combinatie minder zwaar uitvalt. Daarmee wordt prioritering geen abstracte voorkeur voor sneller vervangen, maar een reproduceerbare volgorde op basis van dezelfde criteria. Het kader biedt een manier om die afweging objectief te structureren, zonder te doen alsof elk onderdeel van een legacy-omgeving dezelfde urgentie heeft.
Een gezamenlijke vervangingsdatum kan daarom hoogstens een administratieve planning zijn. Zij maakt geen onderscheid tussen componenten met uiteenlopende risico's en kan zowel onnodige haast als onnodig uitstel veroorzaken.
Bronnen bij deze sectie: Guidance on the Legacy IT Risk Assessment Framework